


Multi-Agenten-Systeme: Architektur vor Agentenanzahl
Wann mehr KI-Agenten wirklich helfen

Agentic AI soll messbaren Mehrwert liefern, ohne vorschnell viele verschiedene KI-Agenten aufzusetzen und erst danach festzustellen, dass Kosten und Steuerbarkeit leiden. Initiativen scheitern selten am Use Case, sondern an der Architekturfrage: Welche Architektur passt zur Aufgabe und wie lässt sich das mit Kennzahlen begründen?
Aktuelle Forschung liefert dafür eine hilfreiche Perspektive: Sie vergleicht Multi-Agent-Architekturen systematisch und zeigt, wann Multi-Agent-Systeme tatsächlich skalieren und wann zusätzliche KI-Agenten die Leistung sogar verschlechtern können, etwa durch Koordinationsaufwand oder Fehlerketten. Die Kernaussage: Skalierung ist vor allem Architektur- und Governance-Arbeit, nicht eine Frage der Agentenanzahl.
Was ist ein Multi-Agent-System?
Ein Multi-Agent-System (MAS) verbindet mehrere spezialisierte KI-Agenten, die eigenständig Aufgaben übernehmen und sich untereinander abstimmen. Statt dass ein einzelner Agent einen gesamten Prozess bewältigt, verteilt das System verschiedene Teilaufgaben auf mehrere Agenten, die gemeinsam auf ein übergeordnetes Ziel hinarbeiten.
Vom PoC zum Multi-Agent-System: Warum Koordination messbar werden muss
Viele Vorhaben starten als PoC: ein KI-Agent, ein Tool, ein Demo-Flow. Beim Skalieren kommen schnell mehrere KI-Agenten hinzu – oft mit Rollen wie Recherche, Planung oder Validierung. Das ist naheliegend, wird aber riskant, wenn man einen Punkt unterschätzt: Ein KI-Agent ist nicht nur eine Chat-Oberfläche. Er ist ein Akteur, der Tools aufruft, Daten verarbeitet und Entscheidungen vorbereitet oder auslöst. Damit steigen die Anforderungen an Kontrolle, Qualitätssicherung, Kostensteuerung und Nachvollziehbarkeit – nicht in der Theorie, sondern im Betrieb.
Die Wahl der Agenten-Architektur lässt sich über Koordinationsmetriken strukturieren, zum Beispiel:
- Overhead (Abstimmung, Übergaben, Konflikte)
- Effizienz (Output pro Budget)
- Redundanz (Doppelarbeit)
- Fehlerverstärkung (Propagation von falschen Zwischenergebnissen)
Wir vergleichen hier fünf Architekturtypen (Single, Independent, Centralized, Decentralized, Hybrid) über viele Konfigurationen hinweg, um Architektur-Effekte möglichst sauber von anderen Faktoren zu trennen.
Statt Multi-Agent-Systeme als Standard zu setzen, hilft ein wiederholbarer Prozess: Aufgabenklasse bestimmen, Architektur ableiten, Quality Gate definieren und anschließend über wenige, klare Kennzahlen steuern. Der Kern ist nicht „mehr parallel“, sondern „gezielt parallel“ – dort, wo es wirklich trägt. Und mit einer Instanz, die Qualität und Risiko aktiv kontrolliert. Koordination ist nicht kostenlos: Es gibt Sättigungseffekte ab einem gewissen Leistungsniveau. Außerdem entscheidet die Topologie, ob Fehler in der Kette vervielfacht oder früh abgefangen werden.
Drei Effekte, die über Erfolg oder Misserfolg eines Multi-Agent-Systems entscheiden
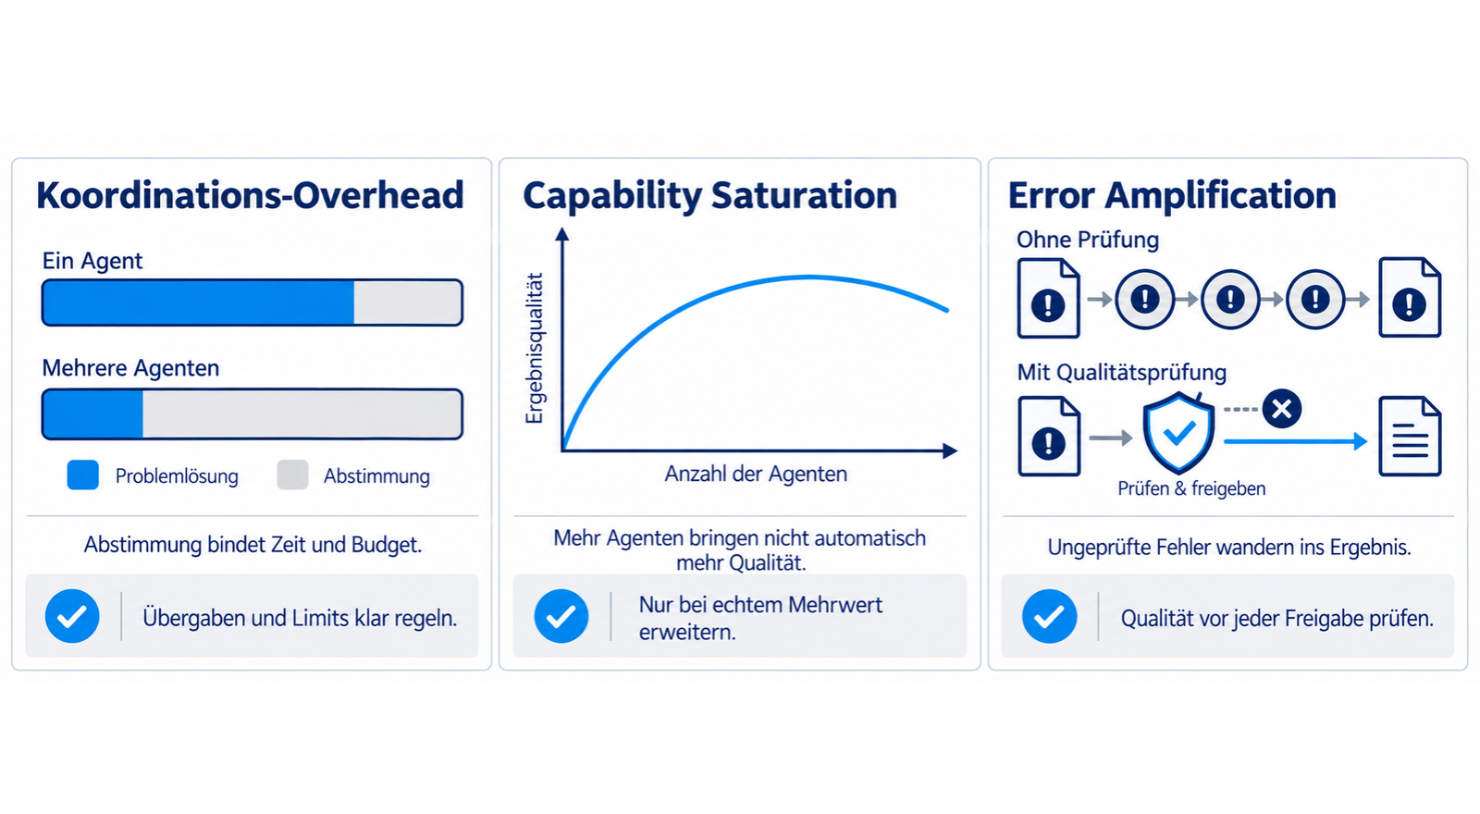
Koordinations-Overhead
Mehr KI-Agenten bedeuten Übergaben, Abstimmungen, Wiederholungen und Konfliktklärung. Unter fixem Budget (Zeit/Token/Compute) kann eine Multi-Agent-System vor allem bei tool- und integrationslastigen Abläufen überproportional verlieren, weil die Koordination Ressourcen bindet, die dann für die eigentliche Problemlösung fehlen. Merksatz: Wenn Tools der Engpass sind, helfen „mehr Agenten“ oft weniger als bessere Orchestrierung plus klare Limits.
Capability Saturation
Ausgehend von einer soliden Single-Agent-Baseline liefern zusätzliche KI-Agenten häufig nur noch geringe – oder sogar negative – Erträge. Praktisch: Wenn ein einzelner KI-Agent eine Aufgabe bereits robust erledigt, werden Multi-Agent Systeme schnell zur Quelle von Komplexität und Betriebskosten, ohne verlässliche Qualitätssteigerung. Deshalb sind sie kein Default-Upgrade, sondern ein Investment, das gut abgewogen werden muss.
Error Amplification
Besonders kritisch ist die Fehlerfortpflanzung: In unkoordinierten Designs – wie zum Beispiel Peer-to-Peer Ketten ohne Zwischenprüfungen – verursachen kleine Fehler am Anfang einer Kette schnell schwere Fehler in den nachgelagerten Schritten, die dann am Ende „selbstbewusst“ im Ergebnis landen. Auch eine zentrale Koordination kann Fehler deutlich besser begrenzen als unabhängige KI-Agenten, deren Ergebnisse erst am Ende zusammengeführt werden. Operativer Schluss: Ohne Quality Gate skaliert nicht nur der Output, sondern auch das Risiko.
Wann lohnt sich ein Multi-Agent-System? Architektur nach Aufgabenprofil auswählen
Als praxistaugliche Vereinfachung hilft eine 2×2-Matrix mit zwei Fragen:
- Wie gut ist die Arbeit parallelisierbar?
- Wie hoch ist die Tool-/Integrationskomplexität?
Daraus lässt sich oft eine robuste Erstentscheidung ableiten, die anschließend über Messwerte verifiziert wird.
Architekturvergleich
Neben der Matrix hilft eine kurze Übersicht, um „Stärke vs. Risiko“ pro Topologie greifbar zu machen. Wichtig ist, Independent nicht automatisch mit „schnell skalierbar“ gleichzusetzen – insbesondere dann nicht, wenn am Ende Aktionen ausgelöst werden sollen. Diese Architekturtypen tauchen in der Praxis auch unter anderen Namen auf – etwa als Supervisor-Worker-Muster (entspricht Centralized) oder Generator-Critic-Loop (ein Hybrid-Muster).
Koordination, Overhead und Fehlerverstärkung sind damit keine Nebeneffekte, sondern zentrale Skalierungsfaktoren, die aktiv gestaltet werden müssen.
Single- und Multi-Agent-System im Unternehmen: Praxisbeispiele
Single-Agent-System im Kundenservice:
Die Bewertung und die Vorverarbeitung eingehender Tickets sollen schnell und kostensparend erfolgen. Hierfür sind nur wenige Tools notwendig und es werden keine geschäftskritischen Aktionen ausgeführt. Eine Single-Agent Lösung würde diesen Fall voll abdecken, während mehrere Agenten zu unnötigem Token-Verbrauch und längeren Verarbeitungszeiten führen würden.
Multi-Agent-System im Schadensmanagement bei Versicherungen
Ein komplexer und geschäftskritischer Ablauf, der Annahme, Prüfung, Koordination, Verarbeitung sensibler Daten und Interaktion mit zahlreichen Tools erfordert, sollte zentral koordiniert und kontrolliert werden, während spezialisierte Agenten anfallende Aufgaben bearbeiten.
Ein robustes Zielbild für den Betrieb
Ein tragfähiger Standardfluss lässt sich branchenunabhängig beschreiben. Am Anfang steht ein klarer Auftrag: Scope, Datenklassen, Zielkriterien. Danach folgt die Orchestrierung: Welche Teilaufgaben sind sinnvoll? Welche Budgets gelten? Welche Tools sind erlaubt? Wann wird eskaliert?
In der Ausführung werden Evidenzen gesammelt und Vorschläge erzeugt. Entscheidend ist der nächste Schritt: Ein Quality Gate prüft Konsistenz und Regeln und erzwingt bei Bedarf eine menschliche Freigabe. Erst danach dürfen Aktionen wirksam werden. Der gesamte Ablauf wird über Observability messbar gemacht, damit Kosten, Fehlerraten und Rework nicht erst im Nachhinein sichtbar werden.
Quellen:
[2512.08296] Towards a Science of Scaling Agent Systems


Verfasst von
Jens Rehpöhler startete seine Karriere 1997 als freiberuflicher Entwickler, bevor er 2001 zu SinnerSchrader wechselte und als Softwarearchitekt an mehreren Online-Banking-Lösungen arbeitete. Nach 4 Jahren wechselte er als Projektleiter zu Arvato CRM (jetzt Teleperformance) und hat die Entwicklung verschiedener CRM-Systeme geleitet. Seit 2020 ist Jens bei Arvato Systems als Leiter der Abteilung AI Solutions tätig, wo er sich mit seinem Team der Entwicklung KI-gestützter Lösungen widmet.